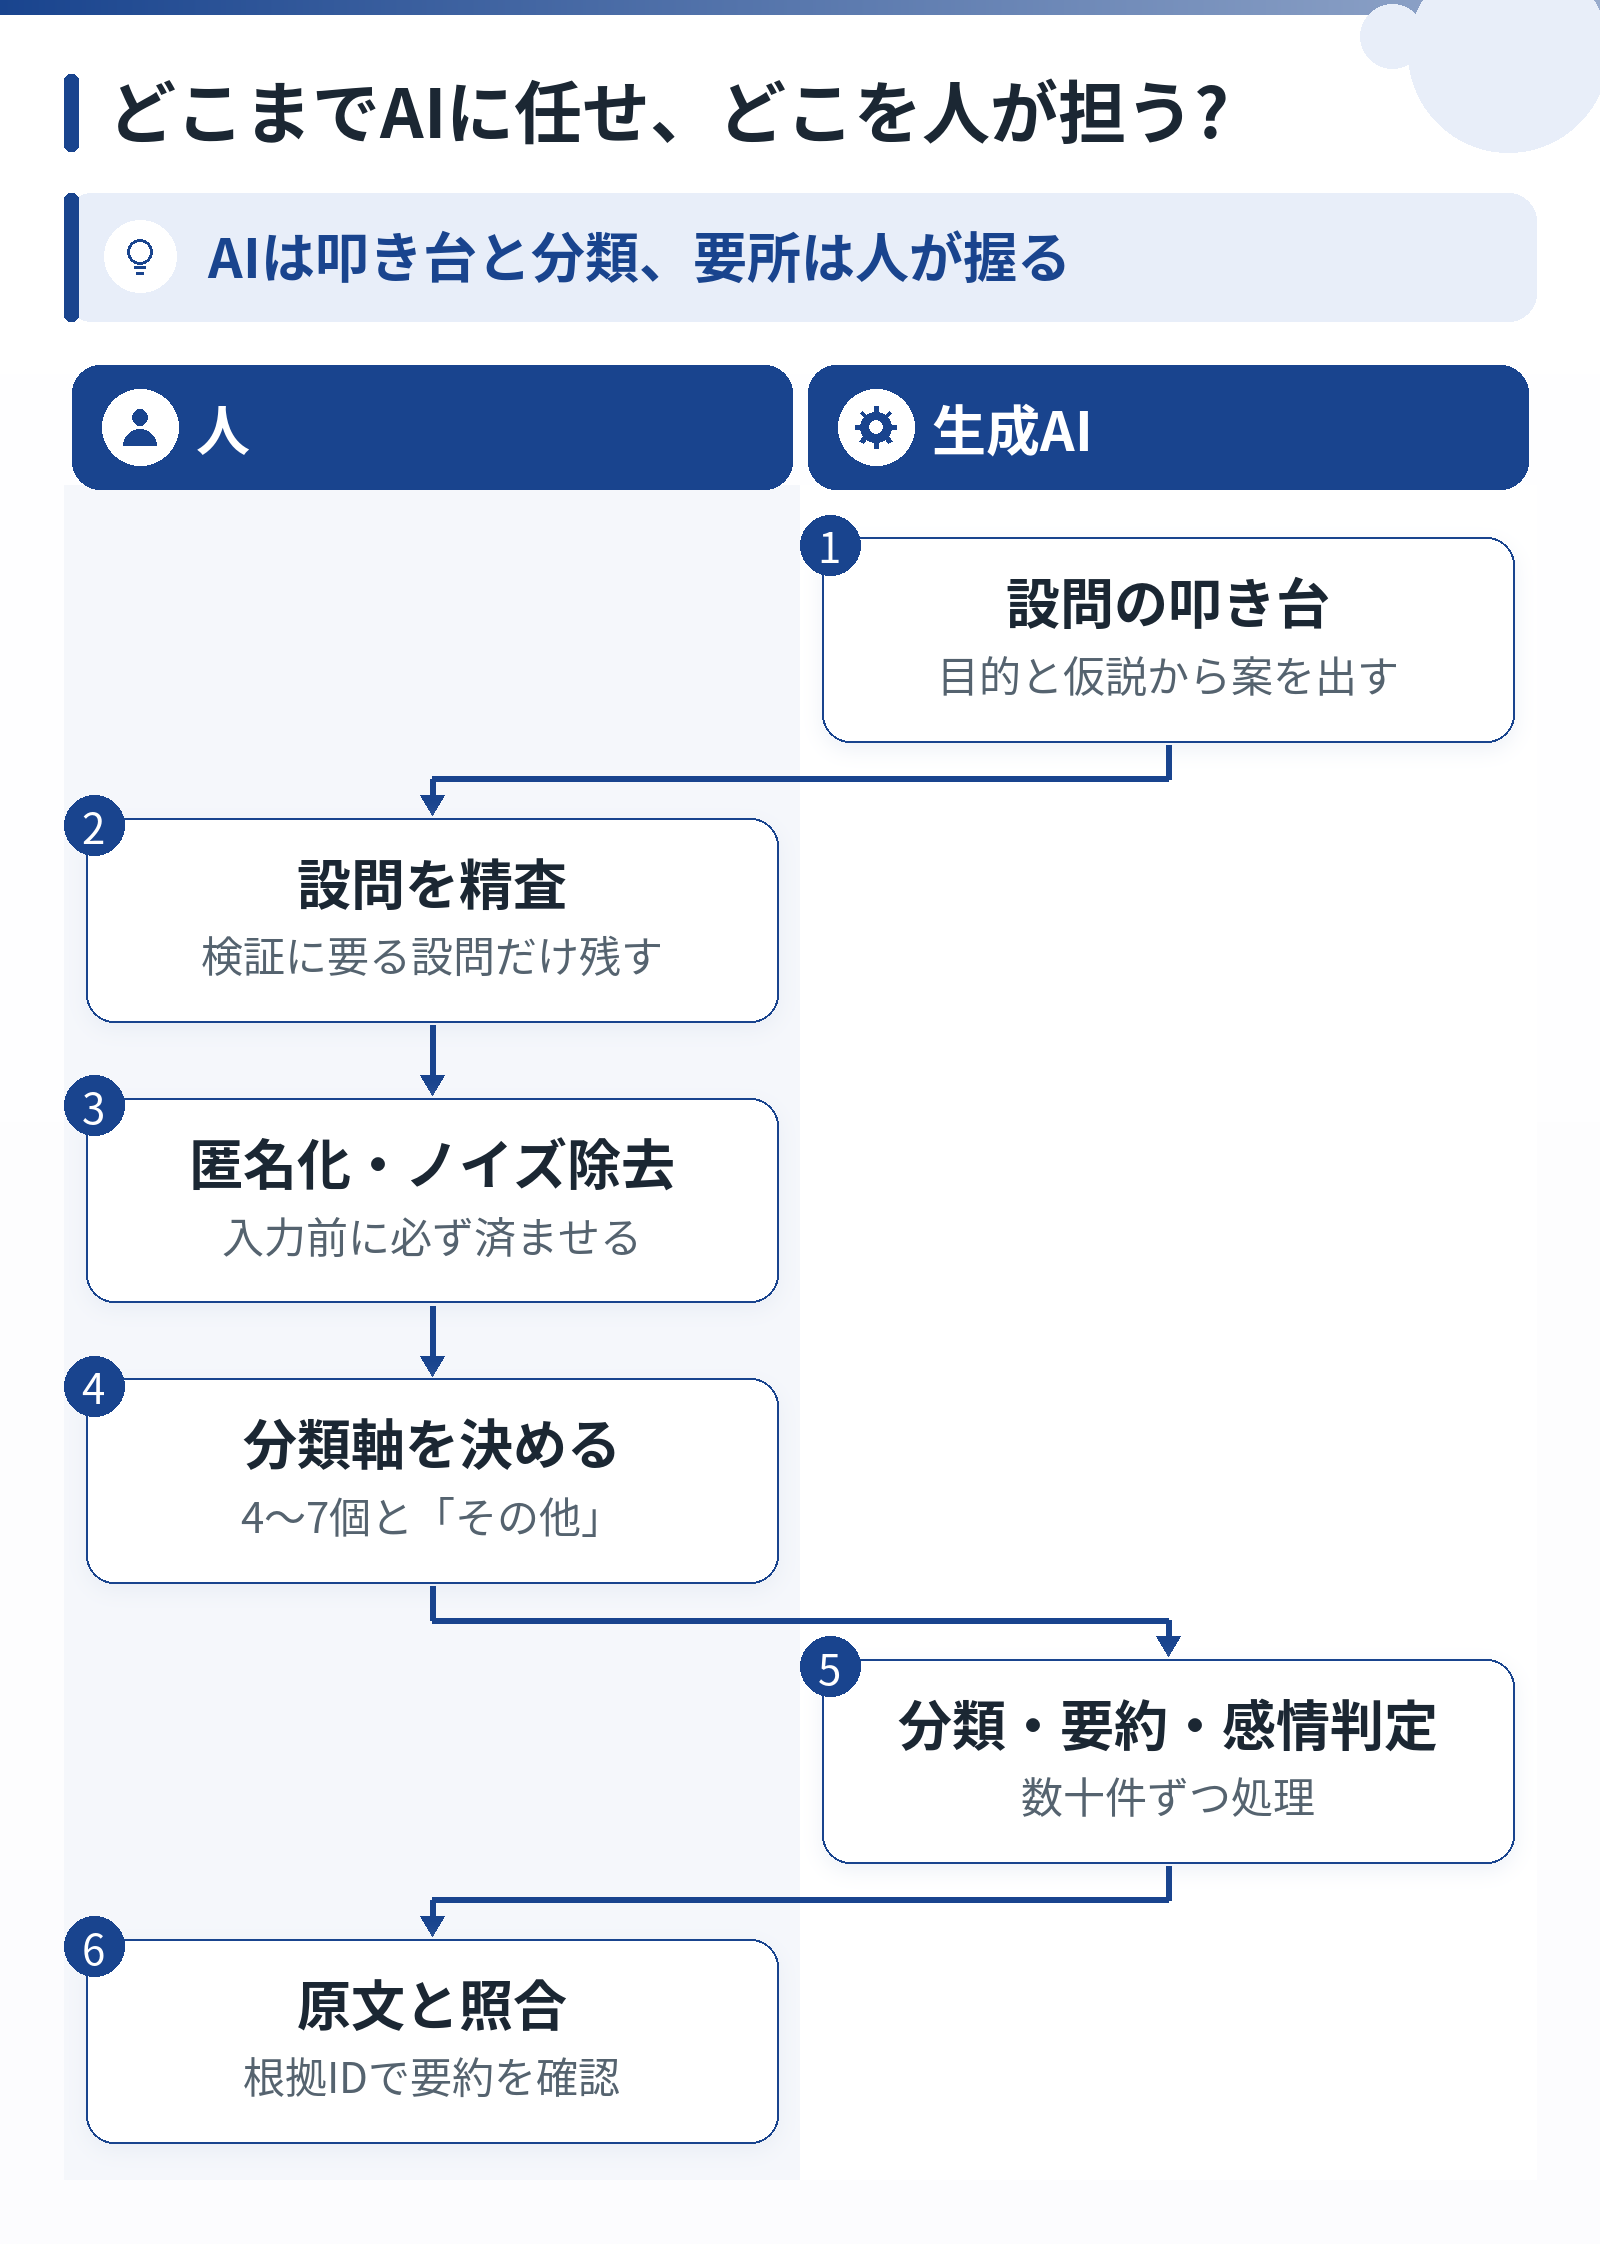
社内アンケートやヒアリングで生成AIを使うなら、「設問の叩き台づくり」と「自由記述の分類・要約」に絞って任せ、匿名化・分類軸の決定・最終確認は人が担うのが基本です。この役割分担を守れば、これまで読み切れずに残っていた自由記述からも、職場の課題を件数や傾向として報告できるようになります。
この記事で分かることは次の3つです。
- 設問を生成AIで作るときの進め方と、人が仕上げるべきポイント
- 自由記述の回答を「前処理 → 分類 → 感情分析 → 検証 → レポート」の順で整理する手順
- 回答データをAIに入力する前に済ませておくプライバシー対策
読み終えたら、手元の数十件の回答で試せるように、入力例・表の例・確認の基準も載せています。
出典: 生成AIで変わるアンケート業務〜設問作成から自由記述分析まで〜chatGPT/Geminiのプロ / アンケートの自由記述をAIで分析する方法|手順・プロンプト・注意点を解説 – スマイルサーベイ / 生成AIで自由記述式アンケートを自動分析、手動の1/10の時短を実現 | ニュースリリース | / 従業員アンケートAIのリアルな実力|5項目の比較表で見極める
前提:対象になる業務と、始める前に用意するもの
対象は、従業員満足度調査、働きやすさに関する社内アンケート、部署ヒアリングのメモなど、自由記述を含む社内の調査です。同じ手順は、顧客アンケートや問い合わせ記録の整理にも応用できます。大量のテキストを分析する技術は、問い合わせ記録やSNS書き込みなどにも使えるとされています6。
この業務で生成AIが役立つ理由は、自由記述の読み込みに時間がかかる点にあります。自由記述は情報量が多い一方、手作業での読解・分析には多くの時間とコストがかかります6。生成AIは文章の意味をもとに分類・要約できるため、担当者を選ばず短時間で分析できるようになりました3。ある試行では、自由記述1,000件の読解・分類・要約にかかる時間が、人が1件ずつ読む場合の10分の1以下になったと報告されています6。ただし、これは1件の試行結果です。自社でも同じ効果が出るとは限らないため、後述の「小さく試す」で確かめてください。
始める前に、次のものを用意します。
- 生成AIのチャットツール:ある検証では、ChatGPTの有料版を標準的な対話機能だけで使い、架空の社内アンケート200件を分析しています7。
- 表計算ソフト:回答の一覧化や表記の置換に使います2。
- 社内の情報取り扱いルール:AIに入力してよい情報の範囲を確認するために使います3。
- 調査の目的を1〜2文で書いたメモ:例として「部署ごとの働きやすさの課題を把握し、来期の改善策の優先順位を決める」のように書きます。
設問の叩き台をAIで作り、人の目で仕上げる
生成AIに「アンケートの質問項目と選択肢を考えてください」と指示すると、質問文と選択肢がそろった案が出てきます1。一見そのまま使えそうに見えますが、この段階の出力は叩き台として扱い、人が精査・調整することが重要です1。
設問を作るときは、集計のしかたも同時に考えておきます。アンケート設計の段階から、AI活用を前提にした仮説立案、設問設定、分析用のデータ表の構造、報告書の形式までを設計するという進め方が示されています6。
選択肢を細かく用意すると、回答者の負担が重くなる設問もあります。そうした設問はあえて自由記述にして、後からAIで分類する設計も実用的です1。消費者調査の例では、品目分類を回答者に選ばせると負担が大きいため、思いついたものを自由に書いてもらい、後で分類する設計にしています1。
手順
- 調査目的のメモと「確かめたい仮説」を書き出します。(例:「残業の多さより、評価の分かりにくさのほうが不満の原因ではないか」)
- 目的と仮説をAIに渡し、設問と選択肢の案を出させます。
- 出てきた案を1問ずつ読み、仮説の検証に必要な設問だけを残します。
- 選択肢が多くなりすぎる設問は、自由記述に切り替えるかを判断します。
- 回答を記録する表の列(ID、部署、各設問、自由記述など)を先に決めておきます。
- 社内の数人に試しに回答してもらい、答えにくい設問を直します。
入力例(架空)
社内の働きやすさを把握するアンケートの質問項目と選択肢を考えてください。目的は、部署ごとの課題を把握して来期の改善策の優先順位を決めることです。仮説は「評価の分かりにくさが不満の主な原因ではないか」です。回答時間は5分以内、設問は8問以内にしてください。選択肢が多くなりすぎる設問は自由記述にして、その理由を添えてください。
判断の基準:残す設問は、「この設問の結果で何を決めるのか」を1文で説明できるものに限ります。説明できない設問は削ります。
回答をAIに入れる前に、匿名化とノイズ除去を済ませる
社内アンケートの自由記述には、氏名や具体的なエピソードが書かれることがあります3。個人を特定できる情報(固有名詞、特定の日付、少人数部署の名前など)は、AIに入力する前に必ず取り除きます2。少人数の部署名は、名前を消しても本人が推測される場合があるため注意が必要です。
学習利用の設定も確認します。入力したデータがAIの学習に使われない設定になっているかを確かめてください3。法人向けの有料プランの一部(ChatGPT Team/Enterprise、Claude for Businessなど)は、データを学習に使わない契約だと紹介されています2。ただし、この点を挙げているのは1つの出典だけです。契約内容は利用する製品やプランによって異なるため、実際の利用規約で確認してください。また、学習に使われない契約であっても、前処理での匿名化は必須の手順とされています2。
あわせて、分析の邪魔になる回答も除きます。「特になし」「?」「うーん」のように中身のない回答、極端に短い回答、決まり文句のような回答は除外の対象です。ノイズが残ったままだと、分析結果に偏りが出るおそれがあります7。「すごく」「とても」「非常に」のような表記の揺れも統一しておきます。この作業は表計算ソフトの置換機能で十分対応できます2。
手順
- 回答を表計算ソフトに貼り、「ID」「部署」「自由記述」の列に整えます。氏名の列は作りません。
- 自由記述の中から、人名・日付・社外の固有名詞・少人数部署名を探し、「[人名]」「[日付]」のような記号に置き換えます。
- 人数の少ない部署は、上位の部門名にまとめるか、部署の列を削除します。
- 「特になし」などの無内容な回答に印を付け、分析対象から外します。
- 表記の揺れを置換機能でそろえます。(例:「すごく」「非常に」→「とても」)
- 利用するAIサービスの学習利用の設定と、社内ルールを確認します。
- 前処理を終えた表を、元データとは別のファイルとして保存します。
置き換えの例(架空)
| 元の記述 | 前処理後 |
|---|---|
| 〇〇さんに先月の会議で否定された | [人名]に[日付]の会議で否定された |
| 3人しかいない△△課は負担が大きい | [部署]は負担が大きい |
| 特になし | (分析対象外) |
確認のしかた:前処理後の表を、調査に関わっていない人に読んでもらい、「誰が書いたか推測できる行はないか」を指摘してもらいます。
分類軸を決めて、AIに回答を振り分け・要約させる
分析の質は、分類軸(カテゴリ)を人が先に決めるかどうかで大きく変わります。軸があいまいなままAIに任せると、分類がぶれてしまいます3。従業員満足度調査であれば、「評価制度」「上司との関係」「働き方」のような軸が考えられます3。どんな軸がよいか迷うときは、AIに数十件を要約させ、出てきた頻出テーマを参考に軸を選ぶ方法もあります3。
指示の冒頭で、AIに役割と前提を与えておく方法もあります。ある検証では、「統計解析と自然言語処理に通じたデータサイエンティスト」という役割を与え、データの構造・分析の流れ・ゴールもあわせて伝えています7。
件数が多い場合は、一度に全件を入れず、数十件ずつに分けて処理すると精度が安定します3。カテゴリへの振り分けと同時に、カテゴリごとの代表的な意見も要約させると、報告用の材料がそろいます3。
手順
- 前処理済みの回答から数十件を取り出し、AIに頻出テーマを要約させます。
- 要約を参考に、人が分類軸を4〜7個程度に決めます。どれにも当てはまらない回答のために「その他」も用意します。
- 各軸の定義を1文で書きます。(例:「評価制度=昇給・賞与・評価面談・評価基準に関する記述」)
- AIに役割・軸の定義・出力形式を伝え、数十件ずつ回答を投入します。
- 結果をIDと一緒に表計算ソフトへ貼り戻します。
- 全件を処理したら、カテゴリごとの件数を集計します。
入力例(架空)
あなたはアンケート分析に慣れたデータ分析の担当者です。以下は社内の働きやすさアンケートの自由記述です(個人情報は削除済み)。
次のカテゴリのどれか1つに分類してください:評価制度/上司との関係/働き方/設備・ツール/その他。
カテゴリの定義:(各カテゴリの1文定義を貼る)
出力は「ID|カテゴリ|分類の理由(20字以内)」の表にしてください。原文にない内容は書かないでください。
最後に、カテゴリごとの代表的な意見を2〜3行で要約してください。
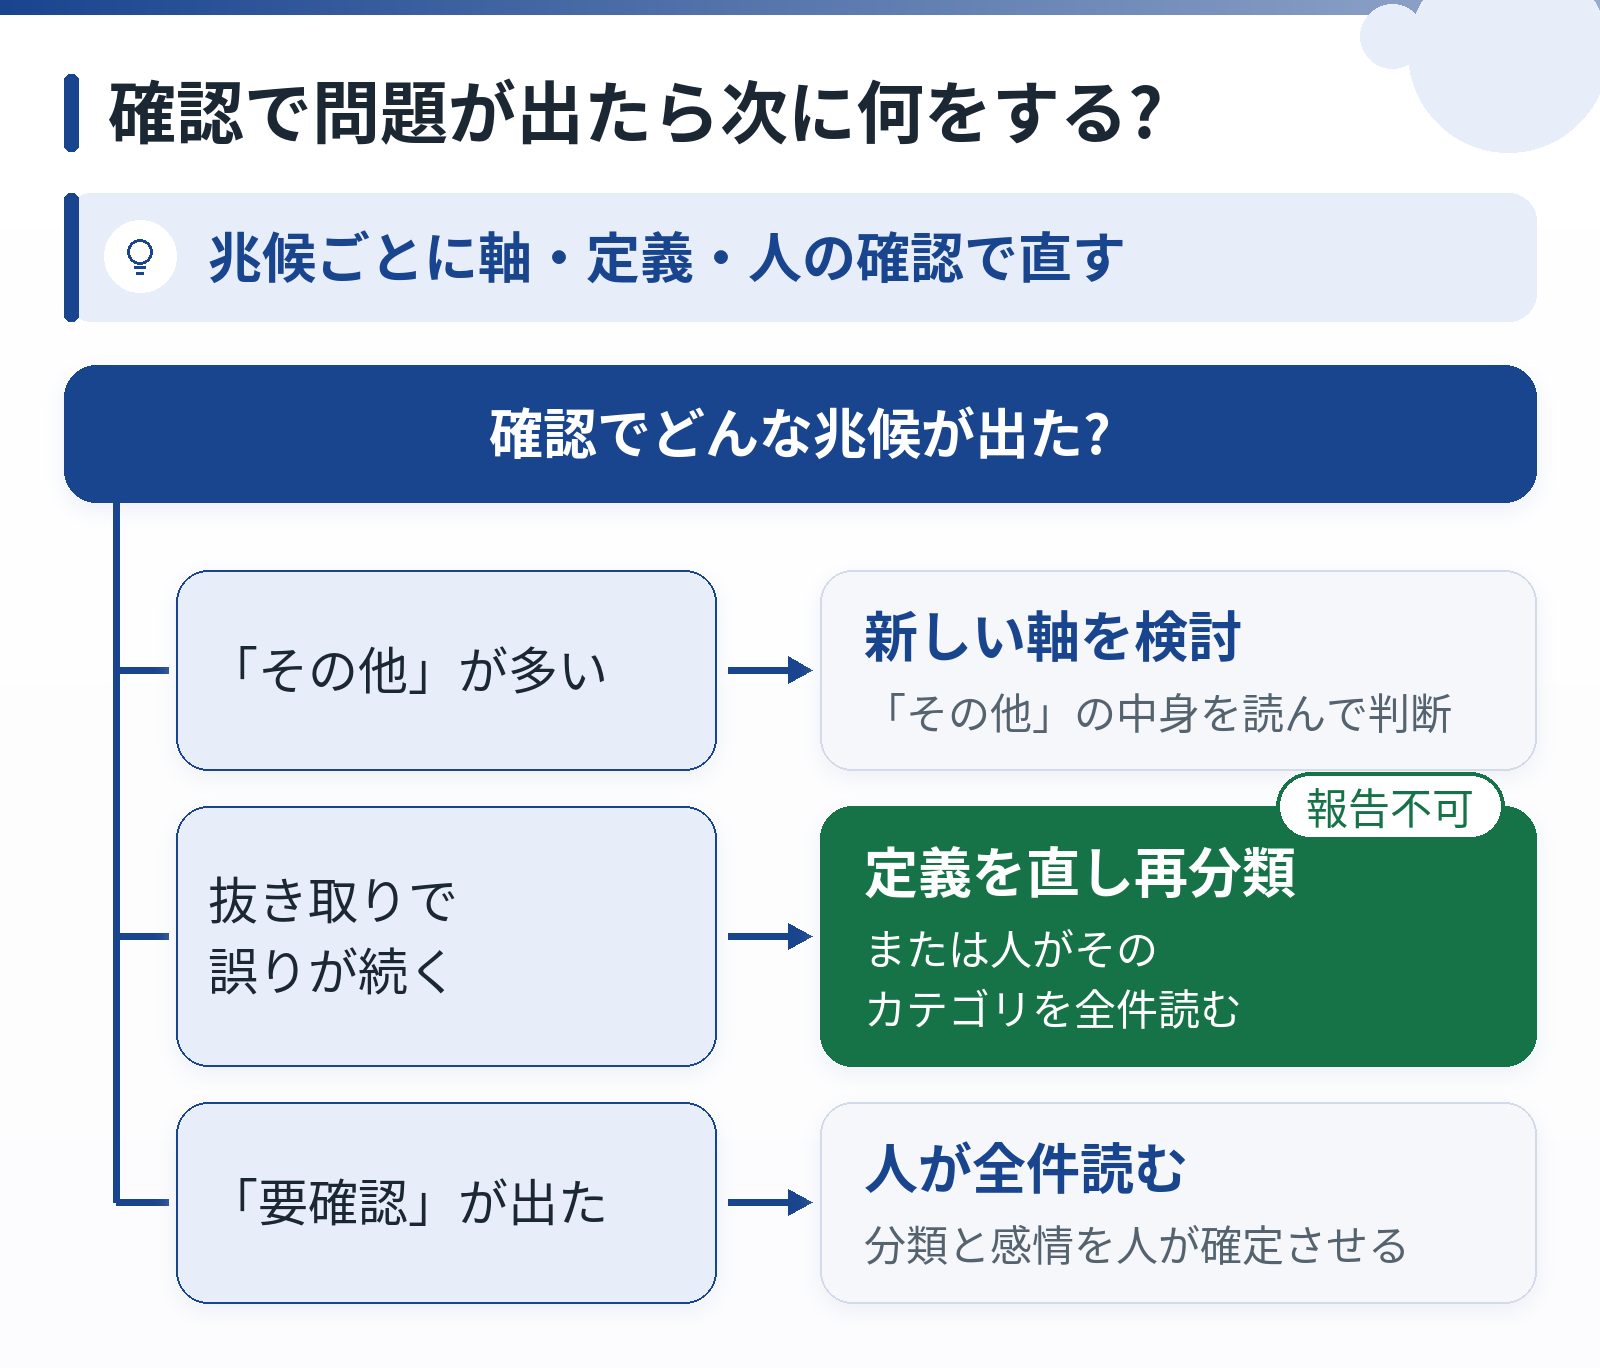
判断の基準:「その他」に入る回答が多い場合は、軸が足りていません。「その他」の中身を読み、新しい軸を追加するかどうかを検討します。
感情分析で、不満が集まるカテゴリを数字で示す
感情分析とは、文章が肯定的か否定的かを判定することです。各回答を「ポジティブ」「ネガティブ」「中立」に判定させ、必要に応じてスコアを付けると、ネガティブな意見が多いカテゴリを定量的に把握できます3。この「カテゴリ分類 → 感情分析 → 課題抽出」の流れは、複数の出典に共通する基本の進め方です2, 3。
数値にしておくと、「不満の内訳は評価制度が◯件、働き方が◯件」のように報告できます3。また、分類基準を事前に決めておけば、誰が作業しても近い結果になり、作業が特定の人に依存しにくくなります3。
手順
- 分類済みの回答に対して、感情の判定を追加で依頼します。
- 判定結果を表に戻し、「カテゴリ × 感情」で件数を集計します。
- 部署の列を残している場合は、部署別の差も集計します。ただし、少人数の部署は個人の特定につながるため集計から外します。
- ネガティブの件数や比率が高いカテゴリに印を付けます。
集計表の例(形式のみ)
| カテゴリ | 件数 | ネガティブ | 中立 | ポジティブ |
|---|---|---|---|---|
| 評価制度 | ◯件 | ◯件 | ◯件 | ◯件 |
| 働き方 | ◯件 | ◯件 | ◯件 | ◯件 |
| 上司との関係 | ◯件 | ◯件 | ◯件 | ◯件 |
判定が難しい回答(皮肉や、肯定と否定が混ざった記述など)は、人が確認する前提で運用します3。AIへの指示に「判断に迷ったものは『要確認』と表示する」と加えておくと、確認すべき行を見つけやすくなります。
結果を原文と照らして確かめ、レポートにまとめる
生成AIは、事実と異なる内容をもっともらしく出力することがあります。これをハルシネーションといいます3, 5。要約に、原文に書かれていない内容が混ざる場合もあります3。そのため、重要な判断に使う要約は、必ず原文と照らし合わせて確認します3。AIの出力に頼りすぎるリスクへの対策も、AI事業者ガイドラインの案で求められています8。
確認が済んだら、出現の傾向や部署ごとの違いから共通の優先課題を取り出し、レポートにまとめます2, 3, 7。
手順(確認のしかた)
- 各カテゴリから数件ずつを無作為に選び、AIの分類が原文の内容と合っているかを人が確かめます。
- 「代表的な意見」の要約について、その根拠となる回答のIDをAIに挙げさせ、原文に本当にその内容があるかを確認します。
- 「要確認」とされた回答はすべて人が読み、分類と感情を確定させます。
- 分類の誤りが目立つカテゴリは、定義の文を直して再分類します。
- 優先課題を2〜3個に絞り、「件数」「代表的な声(原文を要約したもの)」「次のアクション案」の3点でレポートにまとめます。
判断の基準:抜き取り確認で誤りが続くカテゴリは、そのままでは報告に使いません。定義を直して再分類するか、そのカテゴリだけ人が全件を読みます。
うまくいかない場面と、その対処
| 症状 | 考えられる原因 | 対処 |
|---|---|---|
| 同じ回答なのに、実行するたびに分類が変わる | 分類軸の定義があいまい | 各軸の定義を1文で書き、境界にあたる例も添える3 |
| 後半の回答ほど分類が雑になる | 一度に入力する件数が多すぎる | 数十件ずつに分けて投入する3 |
| 「特になし」が1つのカテゴリとして集計される | ノイズ除去をしていない | 前処理で無内容な回答を除外する7 |
| 要約に、誰も書いていない意見が入っている | ハルシネーション | 根拠となる回答のIDを出させ、原文と照合する3 |
| 少数の強い意見が全体の声のように見える | 回答の代表性の偏り | 件数と比率を併記し、回答率や回答者の偏りも記載する |
最後の項目にある回答の代表性の偏りは、個人情報・ハルシネーションと並んで、分析前に押さえるべき注意点として挙げられています3。たとえば、回答率が低い部署の結果は、その部署全体の意見を表しているとは限りません。この場合、レポートには「回答者数」を必ず添えます。
AIへの指示文そのものに偏りが入ることにも注意します。AI事業者ガイドラインに関する資料では、プロンプト(AIへの指示文)に含まれるバイアスに留意し、出力結果を事業で使うかどうかは責任をもって判断することが求められています5。たとえば「評価制度への不満を探して」のように結論を先取りした指示は避け、分類の作業だけを依頼します。
小さく試して、効果を確かめながら改善する(PDCA)
いきなり全社調査で使うのではなく、過去のアンケートの自由記述を数十件使って試すのが安全です。生成AIの活用には、個人情報の漏えいやハルシネーションへの対応など、これまでとは異なる利用者のリテラシーが求められるとされています5。政府のAI事業者ガイドラインは、リスクの大きさに応じて対策の程度を決める「リスクベースアプローチ」を重視しています4。社内で運用ルールを作るときの参考にできます。
手順
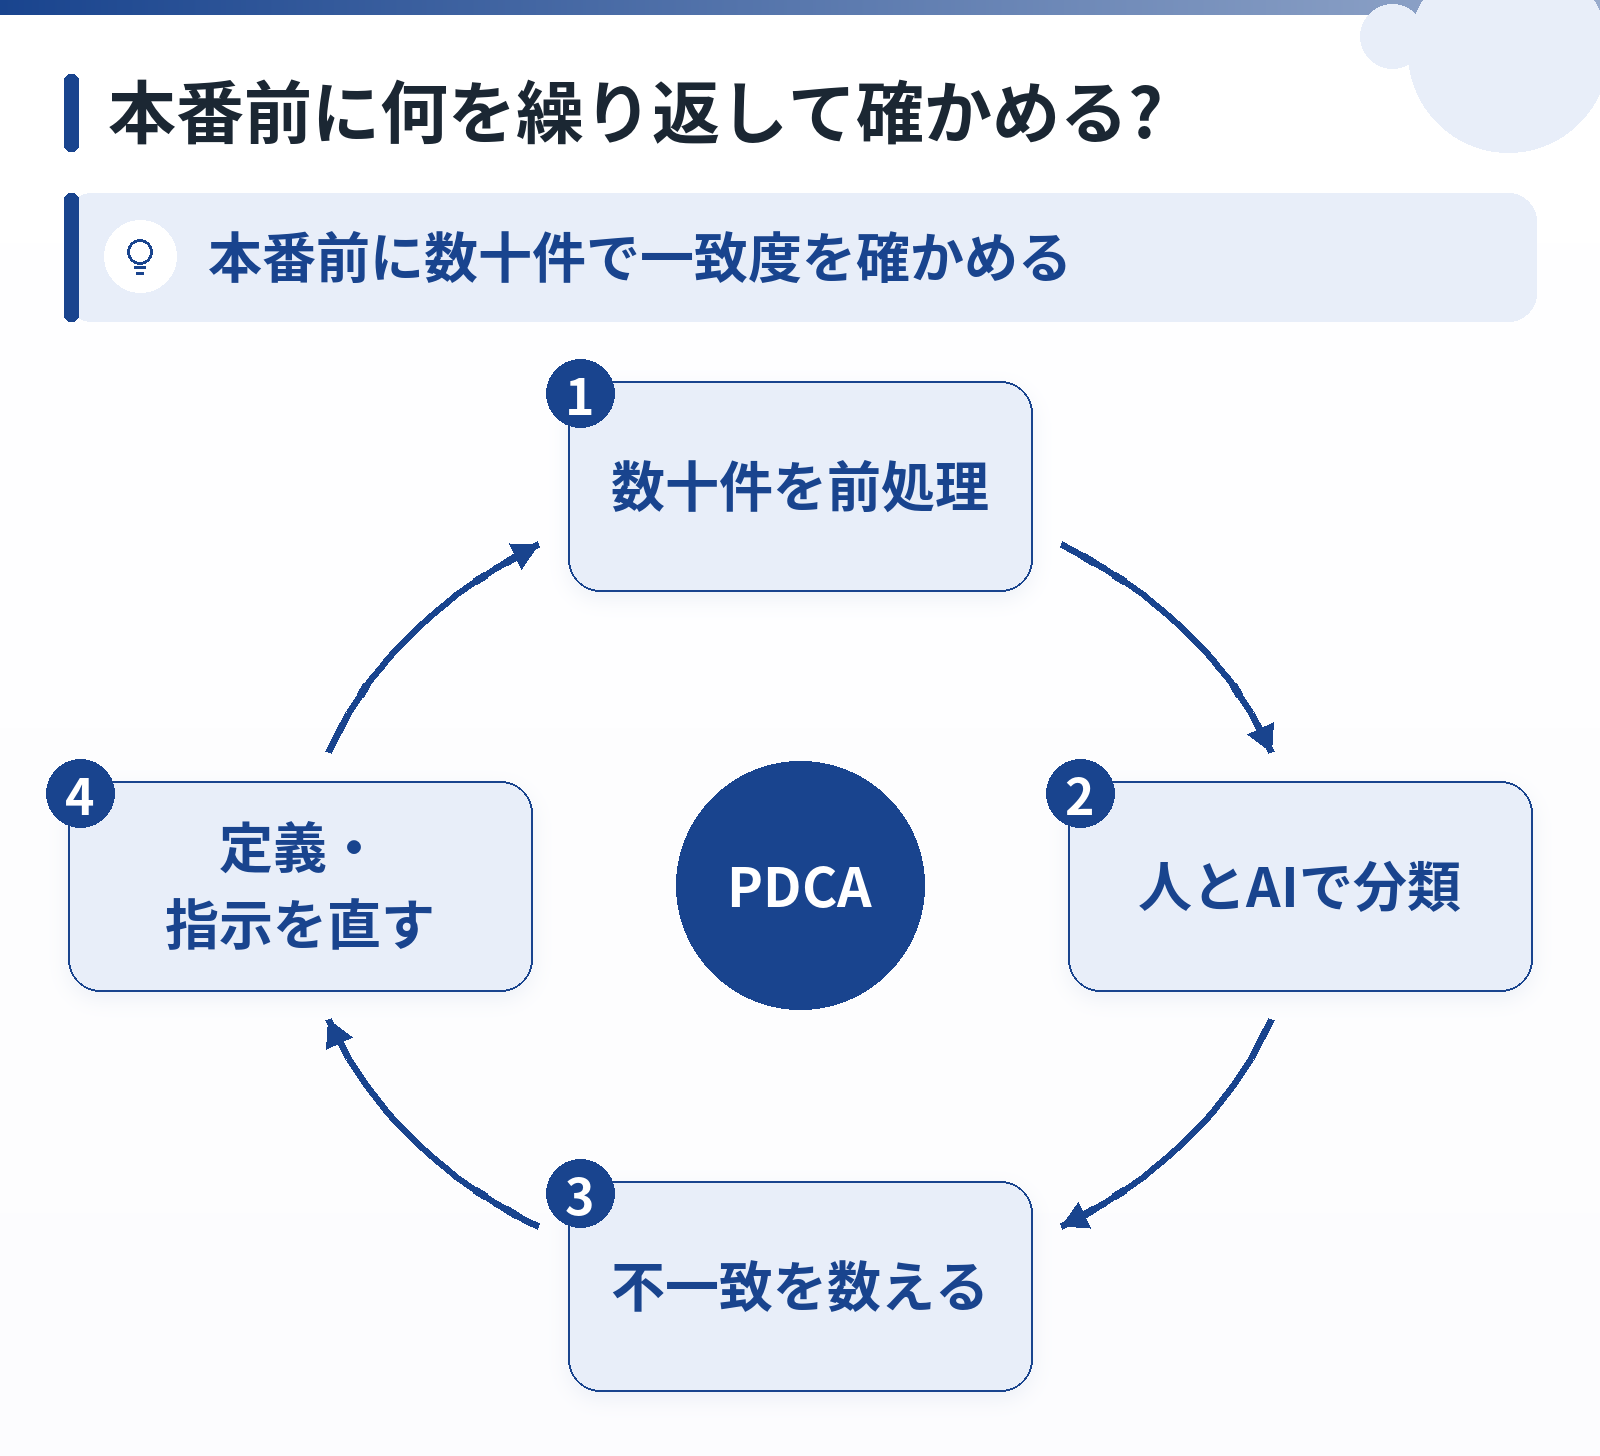
- Plan(計画):過去の回答から数十件を選び、前処理を済ませます。「人が読んだ場合の作業時間」と「分類の一致度」を測ることを決めておきます。
- Do(実行):人が先に同じ数十件を手作業で分類し、かかった時間を記録します。その後、同じ件数をAIに分類させます。
- Check(評価):人の分類とAIの分類を並べ、一致しなかった行を数えます。AIの作業時間には、確認作業の時間も含めて比べます。
- Act(改善):一致しなかった理由を読み、軸の定義・指示文・分割する件数を直します。そのうえで、次の数十件で再び試します。
- 一致度と時間短縮の効果に納得できたら、次回の本番アンケートで使います。前処理と確認の手順は社内ルールとして文書にしておきます。
振り返りの記録例(架空)
| 回 | 件数 | 人の作業時間 | AI+確認の時間 | 不一致の件数 | 次に直すこと |
|---|---|---|---|---|---|
| 1回目 | 数十件 | (記録) | (記録) | (記録) | 「働き方」と「設備」の境界の定義を書き直す |
| 2回目 | 数十件 | (記録) | (記録) | (記録) | 「要確認」の出力指示を追加する |
まとめ:最初の一歩
生成AIは、アンケート業務のうち「設問の叩き台づくり」と「自由記述の分類・要約・感情判定」を短時間で進める道具として使えます1, 3, 6。一方で、回答の匿名化、分類軸の決定、原文との照合、最終的な判断は人の仕事として残ります2, 3。
まずは、手元にある過去のアンケートの自由記述を数十件選び、次の順で1回試してください。
- 個人情報を取り除く
- 分類軸を4〜7個決める
- AIに分類させる
- 人の分類と比べる
その結果をもとに、指示文と軸の定義を直していけば、次の調査から自社に合ったやり方で使えるようになります。
出典・参考
- 【1】生成AIで変わるアンケート業務〜設問作成から自由記述分析まで〜chatGPT/Geminiのプロンプトと回答つき
- 【2】従業員アンケートAIのリアルな実力|5項目の比較表で見極める
- 【3】アンケートの自由記述をAIで分析する方法|手順・プロンプト・注意点を解説 – スマイルサーベイ
- 【4】AI 事業者ガイドライン
- 【5】生成AI利活用に係る今後の対応方針等について
- 【6】生成AIで自由記述式アンケートを自動分析、手動の1/10の時短を実現 | ニュースリリース | MRI 三菱総合研究所
- 【7】生成AIで読み解く“自由記述”― ChatGPTで始める定性データ分析の第一歩― | 株式会社 ロイヤリティ マーケティング
- 【8】AI 事業者ガイドライン案
コメント